Зачем бизнесу смотреть на бенчмарки агентов
Когда разработчики моделей выпускают новый релиз, они часто публикуют высокие проценты точности на школьных тестах по математике или олимпиадном коде. Для предпринимателя эти цифры мало что говорят: в реальном бизнесе агенту нужно не решать интегралы, а принять клиента в WhatsApp, уточнить нужную услугу, сверить расписание и сохранить сделку в CRM без ошибок.
За последние два года исследовательские лаборатории (Sierra, Salesforce, OpenAI, Stanford) создали специализированные бенчмарки агентного взаимодействия. Они воспроизводят живую работу с базами данных, политиками обслуживания и многоходовыми диалогами.
Главный вывод этих исследований отрезвляет: даже передовые языковые модели пока не готовы к полной бесконтрольной автономности. Ниже разберём, как именно измеряют надёжность агентов и почему в надёжной системе человек остаётся обязательным участником процесса.
Метрика pass^k в τ-bench: почему разовый успех обманчив
Один из самых авторитетных академических тестов для диалоговых агентов — τ-bench (tau-bench), разработанный исследователями Sierra и Принстона [1]. В нём симулируется клиентская поддержка в ритейле и авиаперевозках: агент использует API-инструменты, сверяется с правилами возврата и общается с клиентом.
Авторы ввели фундаментальное различие между разовой точностью (pass^1) и эксплуатационной надёжностью (pass^k):
- pass^1 показывает, с какой вероятностью агент решит задачу с одной попытки. Для ведущих моделей в ритейле этот показатель достигал 61,2%.
- pass^k требует, чтобы агент безошибочно выполнил цепочку из k похожих задач подряд.
На практике при k=8 показатель успешности падает ниже 25% [1]. Это означает: агент может великолепно ответить одному клиенту, но на дистанции из восьми обращений подряд он почти наверняка допустит сбой хотя бы в одном диалоге, если у него нет строгих ограничений.
Почему происходят сбои
Анализ ошибок в исследовании τ-bench выявил три главные причины неудач агентов:
- 55% ошибок — неверные аргументы API или неверно понятые параметры клиента (например, перепутано время визита или артикул).
- 25% ошибок — отклонение от установленных бизнес-правил компании (агент пообещал скидку, которой нет в тарифе, или пропустил обязательный вопрос).
- 19% ошибок — неполное выполнение составных запросов, когда клиент попросил сделать два действия сразу.
Если убрать из системных инструкций чёткие границы правил, точность моделей на сложных процессах падает более чем в три раза [1].
CRMArena-Pro: как агенты работают с корпоративными базами данных
Исследовательская группа Salesforce AI Research представила бенчмарк CRMArena-Pro [2], моделирующий реальные операции в CRM: маршрутизацию сделок, уточнение цен и сервисную поддержку.
Бенчмарк показал контраст между технической маршрутизацией и диалогом:
- Исполнение прямых действий (Workflow Execution): модели отлично справляются с фиксацией полей и маршрутизацией карточек — точность превышает 83%.
- Многоходовый диалог (Multi-turn interaction): при переходе от одного действия к долгой переписке из нескольких реплик успешность падает примерно до 35% [2].
Причина в накоплении неопределённости: чем дольше длится свободный разговор без фиксации промежуточных итогов, тем выше шанс, что модель потеряет контекст исходного запроса.
Исследование OpenAI GDPval и формула «ИИ + человек»
В исследовании GDPval от OpenAI [3] эксперты с многолетним опытом оценивали работу моделей по сотням профессиональных задач из ключевых отраслей экономики.
Исследование проверило сценарий: «модель генерирует решение, а человек проверяет и при необходимости дорабатывает». Результаты показали:
- Реальное рабочее ускорение составляет от 1,12× до 1,39×, а не десятки раз, как заявляют рекламные слоганы [3].
- Около 3% действий полностью автономных моделей классифицированы как критические сбои, которые человек сразу видит и отсекает.
Это согласуется с фундаментальным исследованием экономистов из Стэнфорда и MIT, опубликованным в Quarterly Journal of Economics (QJE 2025) по данным работы более 5 000 операторов клиентской поддержки [4]. Внедрение ИИ-подсказок увеличило среднюю производительность на 15%, а для начинающих сотрудников — на 34%, при этом максимальный эффект достигался именно тогда, когда человек сохранял контроль за принятием решений.
Актуальные замеры Artificial Analysis: скорость, задержка и агентная надёжность
Независимый трекер Artificial Analysis на регулярных прогонах ведущих мировых моделей [5] фиксирует две ключевые характеристики для диалоговых систем: качество рассуждений (Quality Index / SWE-bench) и задержку ответа:
| Модель | Индекс качества | Задержка первого токена (TTFT) | Скорость генерации | Агентная точность (SWE-bench Verified) |
|---|---|---|---|---|
| Claude 3.5 Sonnet | 88 | 0,78 с | ~71 токен/с | 49,0% |
| GPT-4o | 84 | 0,42 с | ~82 токена/с | 38,8% |
| Gemini 1.5 Flash | 76 | 0,28 с | ~145 токенов/с | 22,0% |
| Llama 3.1 70B (Groq) | 78 | 0,22 с | ~250 токенов/с | 26,0% |
Свежие замеры наглядно показывают компромисс:
- Для быстрого приветствия и классификации намерений оптимальны сверхбыстрые модели с TTFT менее 0,3 с (Gemini Flash, компактные Llama на быстрых чипах).
- Для сложных многошаговых сценариев (бронирование времени, пересчёт корзины с акциями) требуются флагманские модели (Claude 3.5 Sonnet, GPT-4o). При этом даже на передовых моделях точность в сложных многоходовых цепочках редко превышает 50% без жёстких ограничений правил.
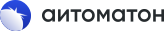
Как эти выводы реализованы в платформе Aitomaton
Результаты бенчмарков легли в основу инженерных принципов платформы Aitomaton [6]:
- Ролевые границы вместо свободного сочинения. Агент действует строго в рамках выданной роли: он запрашивает конкретные поля, сверяется с расписанием и не генерирует произвольных обещаний.
- Теневой режим перед запуском (Shadow Mode). Новый агент сначала тестируется на реальных входящих диалогах: система показывает, как он ответил бы, а команда проверяет логи и след хода до того, как доверить общение клиентам.
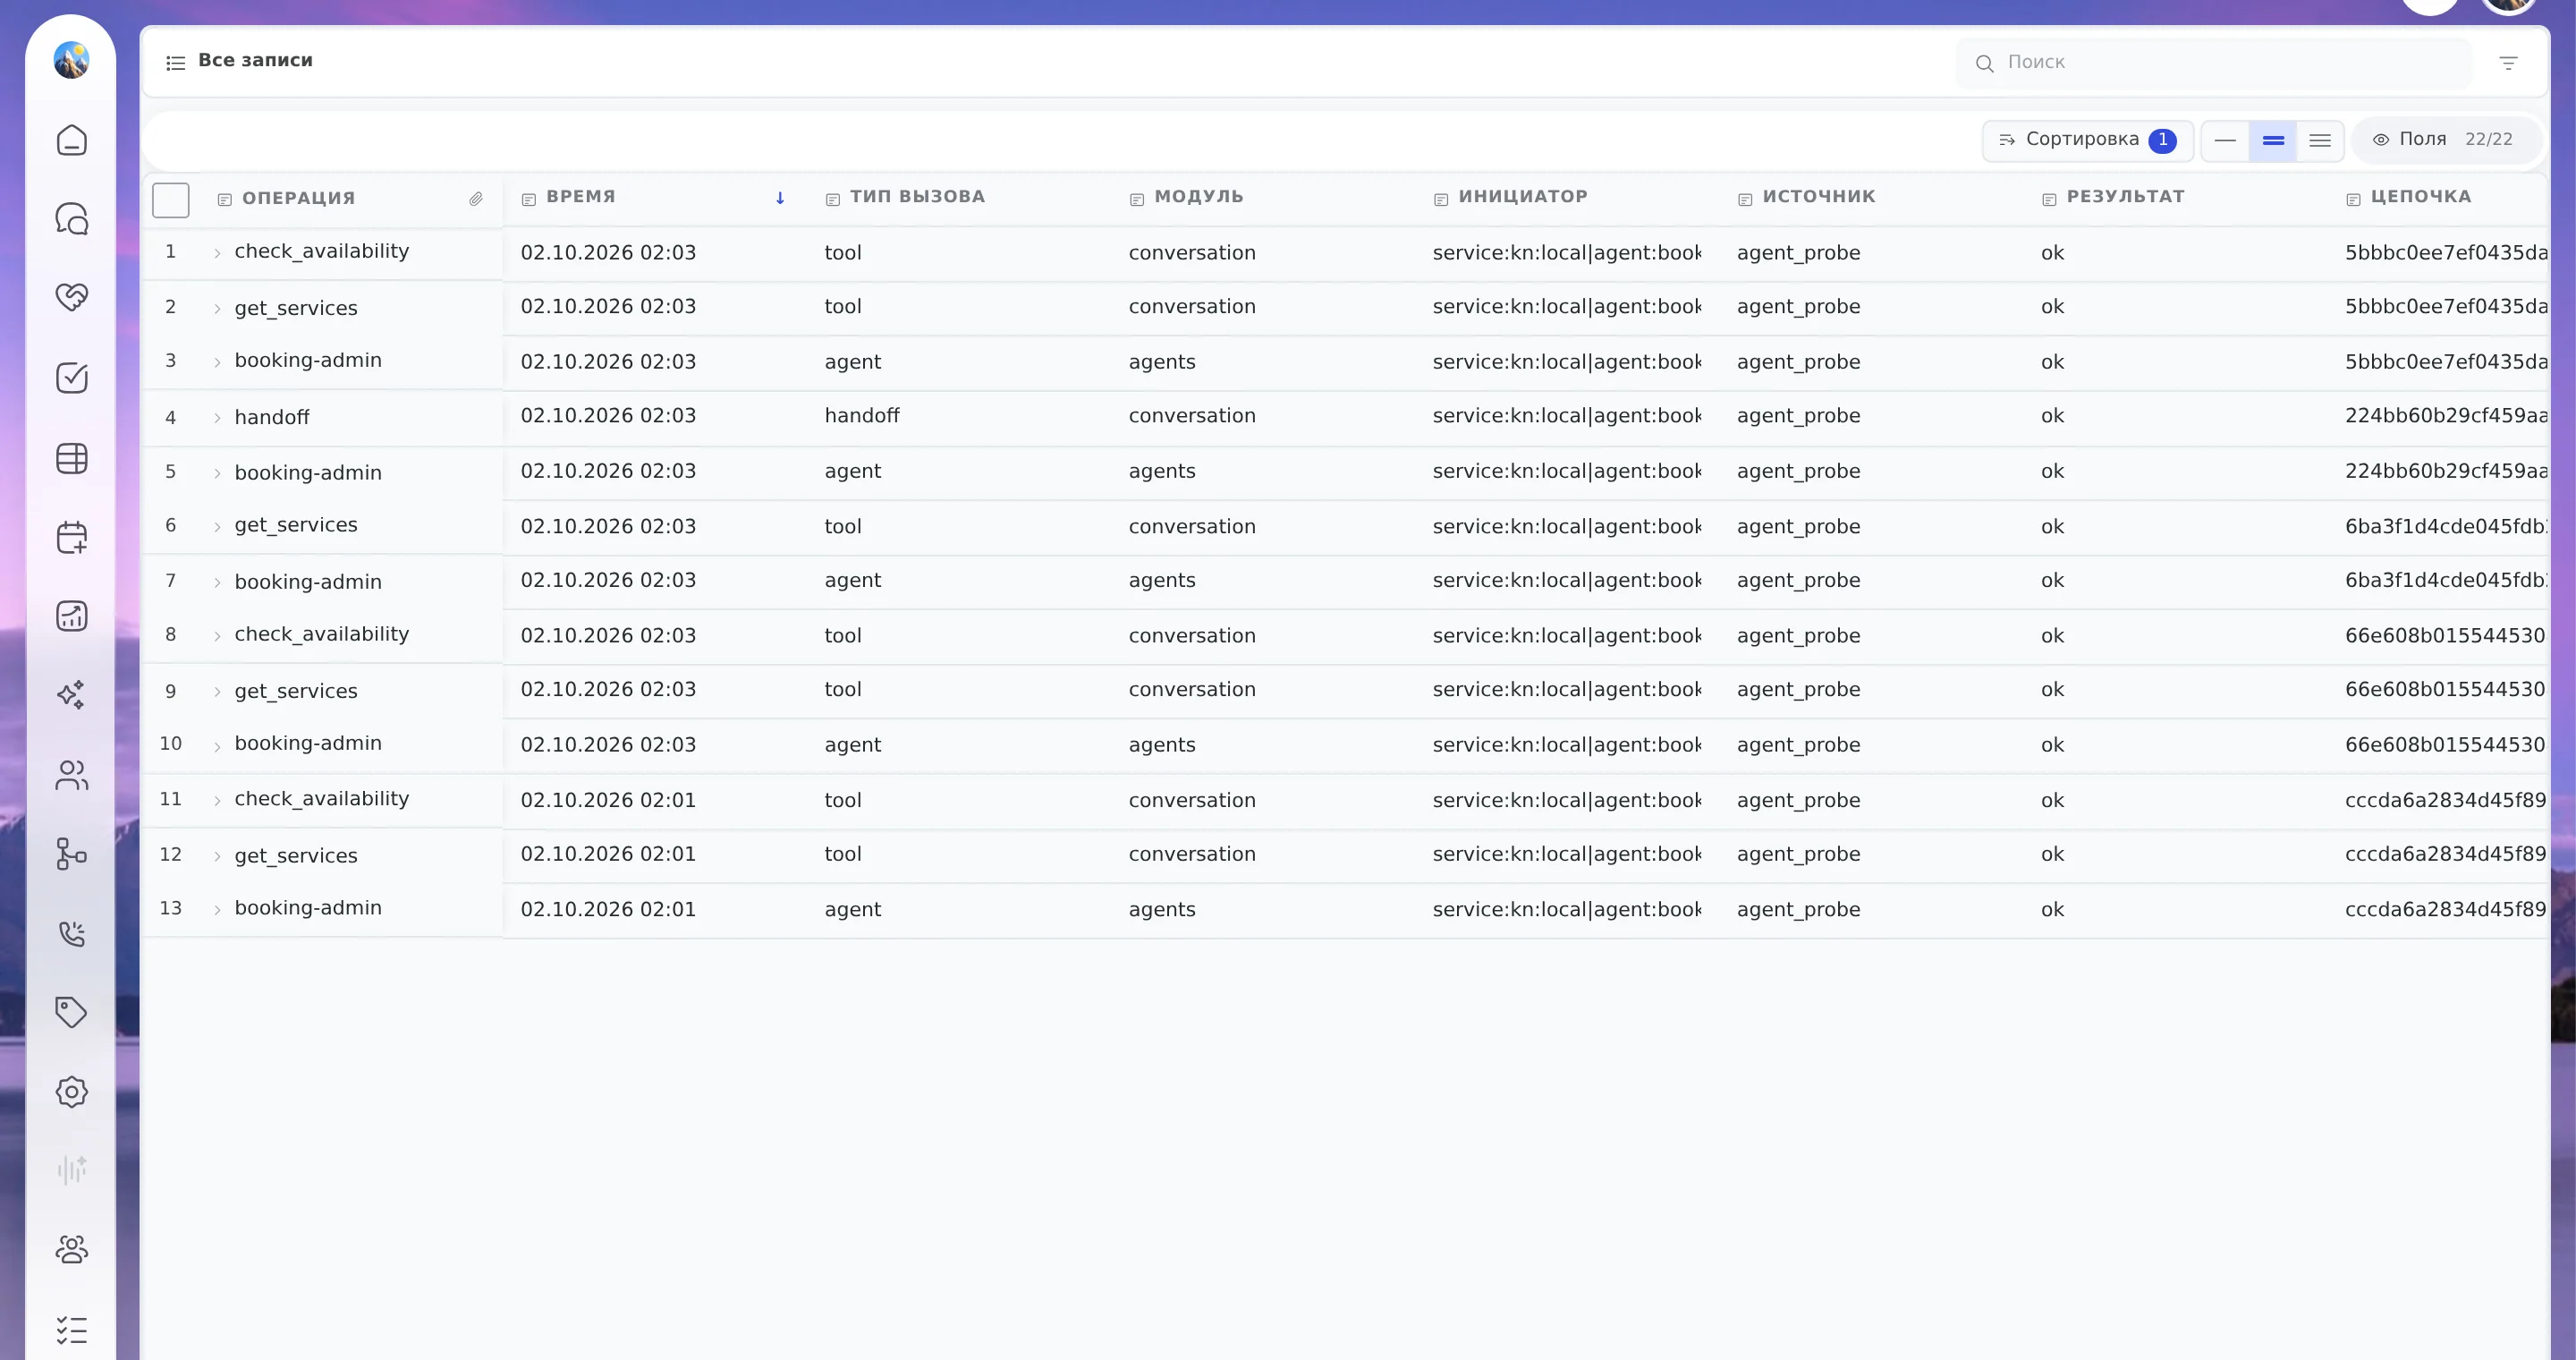
- Мгновенная эскалация человеку. Если клиент задаёт нестандартный вопрос, выражает недовольство или требует индивидуальных условий, агент не пытается импровизировать — он переводит диалог дежурному менеджеру и передаёт готовую карточку со всей историей переписки в CRM.