Что мы измерили и зачем?
Чтобы не полагаться на абстрактные заявления о «99% точности» и понять реальные ограничения открытых технологий, мы провели прикладной инженерный тест: написали воспроизводимые скрипты и прогнали офлайн-движок Tesseract 5.5.0 CLI по четырём синтетическим образцам казахского текста.
Мы проверяли не «весь казахский язык в реальном мире» (для этого требуются тысячи полевых документов), а конкретную инженерную гипотезу: как базовые открытые модели traineddata справляются с девятью специфическими буквами — ә, ғ, қ, ң, ө, ұ, ү, һ, і — без нейросетевой постобработки, и где движок подменяет их русскими аналогами.
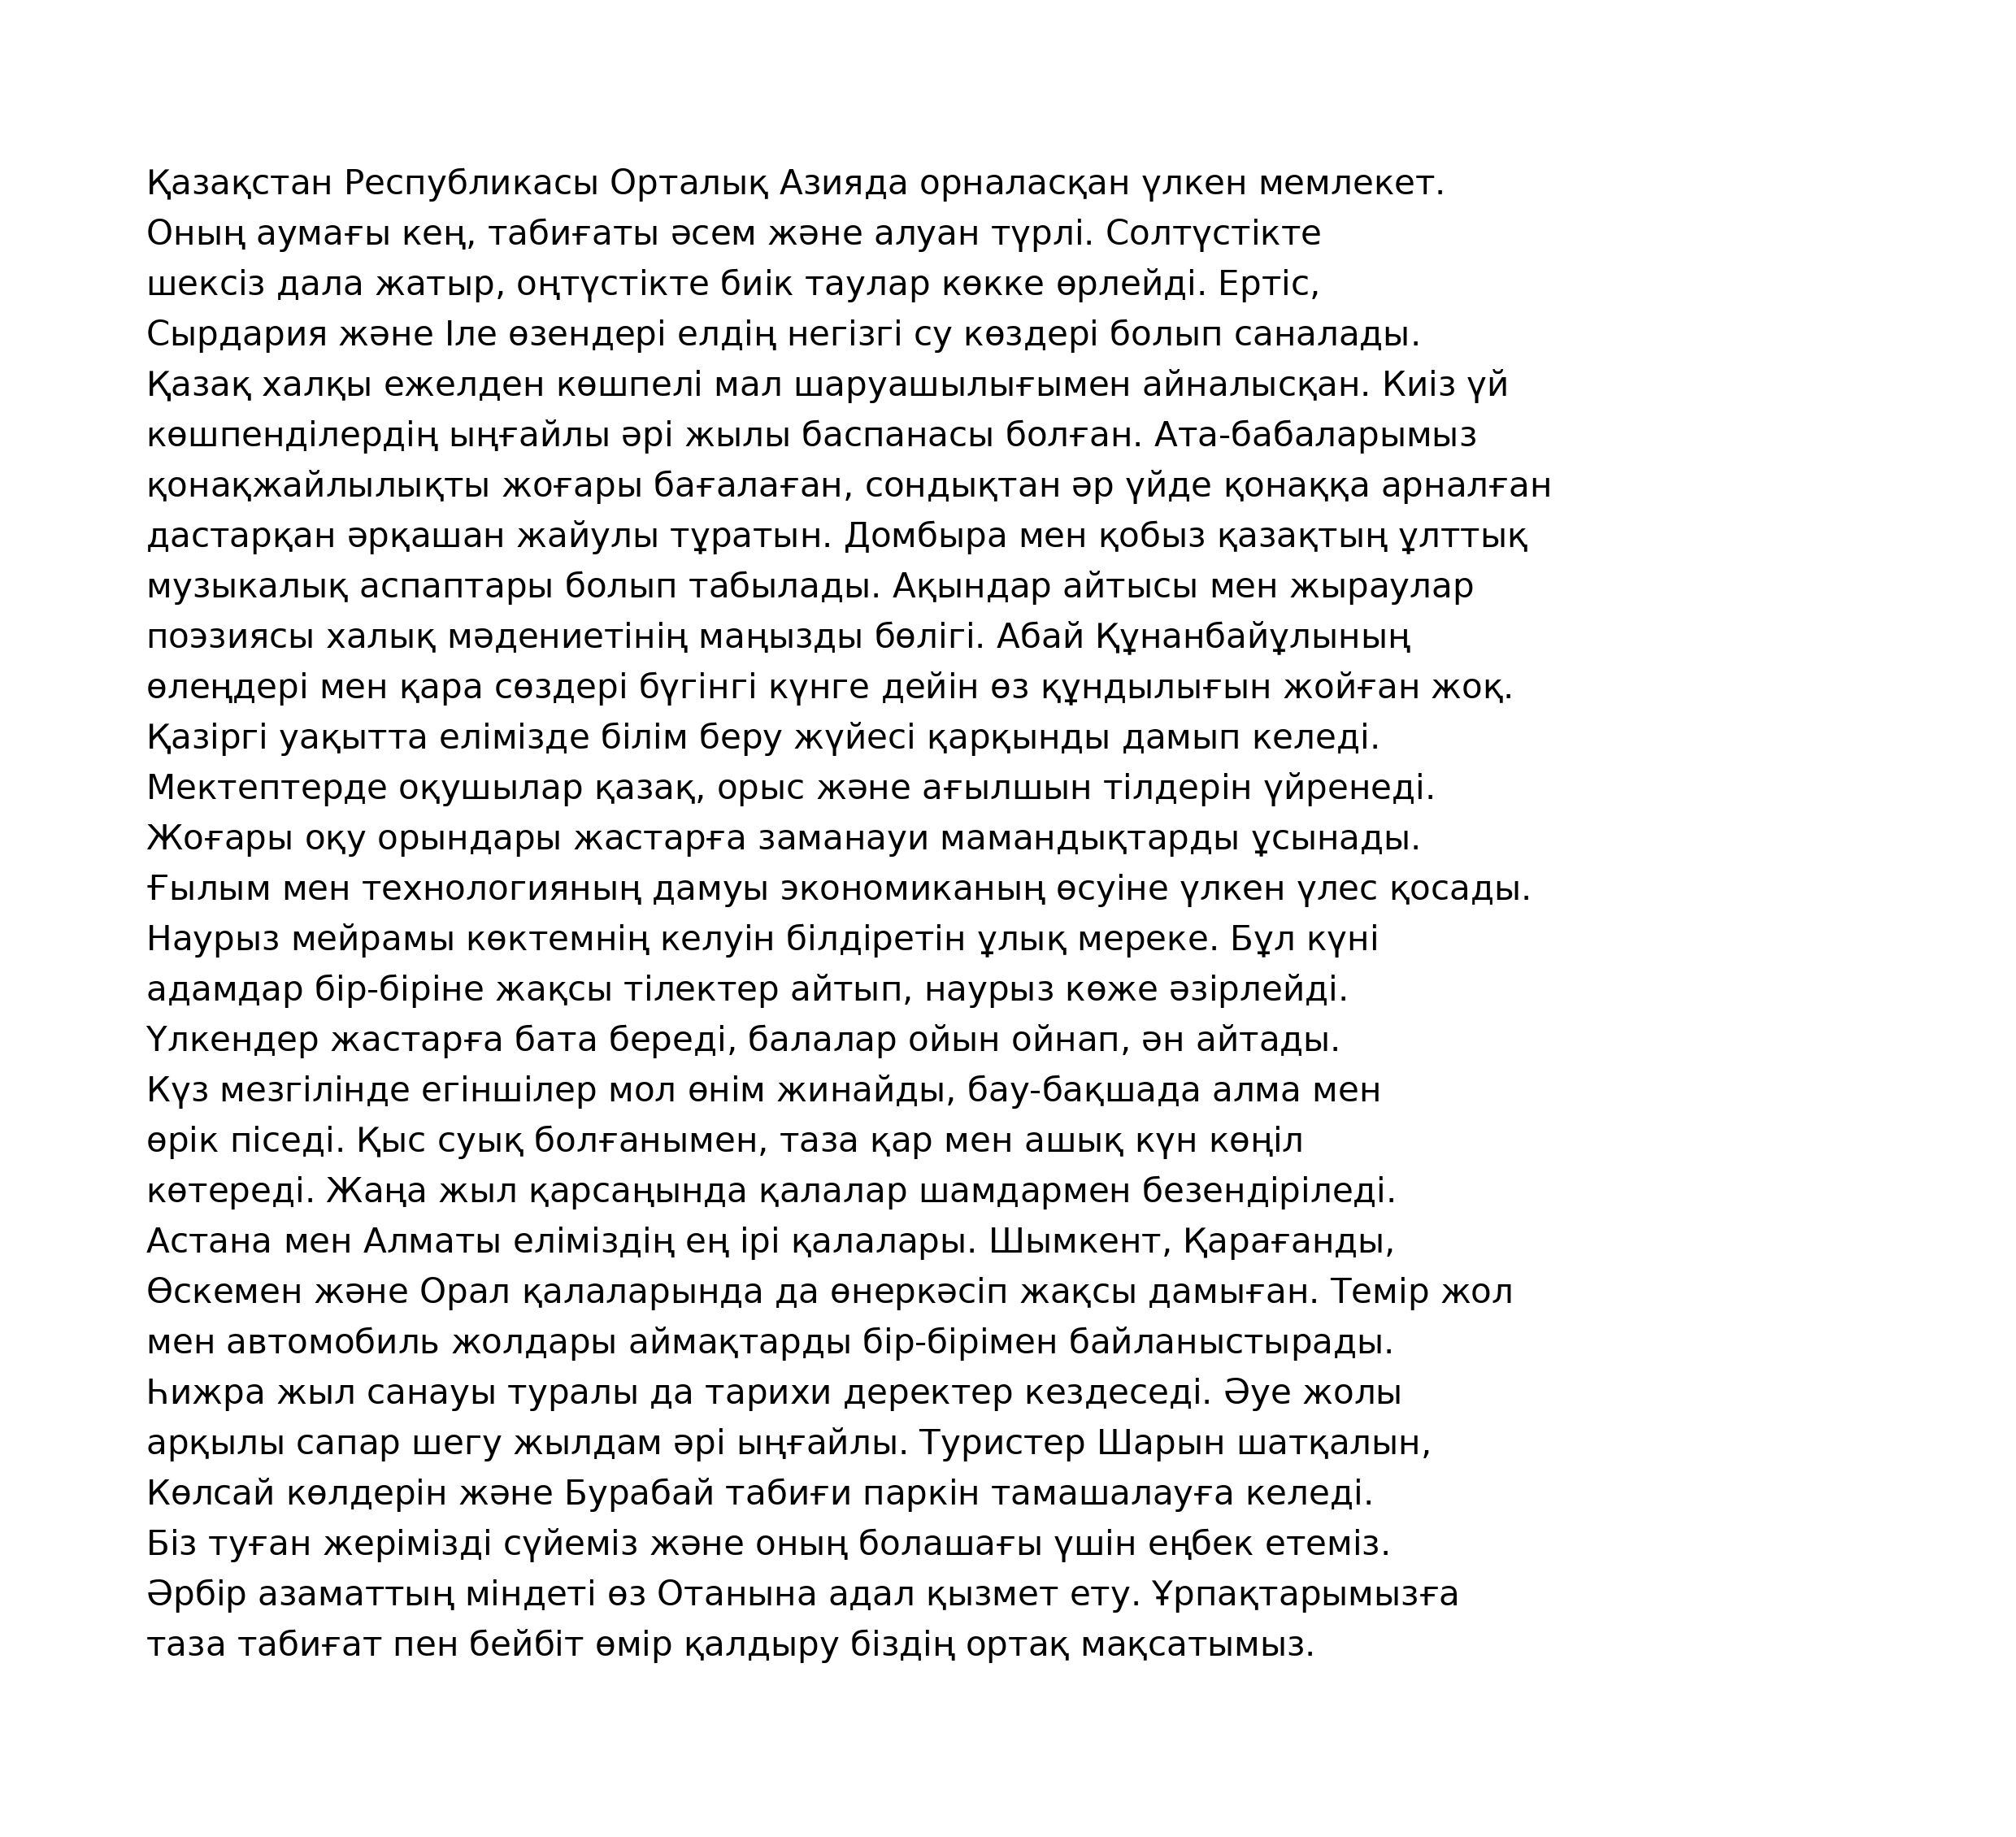
Это полностью открытый замер: генератор страниц render.py, скрипт оценки score.py, тестовые файлы и CSV-логи выложены рядом, чтобы любой разработчик мог повторить тест одной командой.
Мерили именно голый офлайн-движок, а не готовую цепочку с предобработкой изображений. Внутри веб-сервисов распознавание часто работает через tesseract.js или VLM-модели — это другие инструменты, и наш замер описывает базовый CLI-движок. Постобработку мы намеренно не включали: важно увидеть поведение «как есть».
Причина простой на первый взгляд задачи в том, что казахский алфавит близок к русскому, но девять букв устроены иначе. Движок, натренированный на русском, привычно подставляет двойники — и там, где речь о реквизитах, суммах или названиях, такая замена меняет смысл. Поэтому смотреть на общую точность мало: нужен разрез по буквам.
Когда часть клиентов пишет и присылает документы по-казахски, а распознавание уже стоит в продукте, я хочу понять, ошибётся ли движок на казахских буквах и где именно, чтобы доверять распознаванию там, где это безопасно, и оставлять человеку то, что дорого стоит.
Как устроена методика замера?
Методика простая и воспроизводимая: четыре синтетических образца, три набора моделей, три набора языков и единая метрика ошибок. Документы отрисованы шрифтом DejaVu Sans при 300 dpi, эталоны лежат в gt/, распознанные тексты — в out/. CER и WER считает библиотека jiwer после схлопывания пробелов.
Движок один — tesseract 5.5.0 (leptonica 1.84.1), LSTM, режим --psm 3. Модели брали в трёх вариантах: системные из пакета tesseract-ocr-kaz/rus (это tessdata_fast), точные tessdata_best и web-сборку, которую использует DocScan. Сами файлы моделей мы в репозиторий не кладём — они под Apache-2.0, поэтому ниже только ссылки на оригиналы и sha256.
Образцы подобраны так, чтобы задеть разные сценарии: чистый печатный казахский текст на 300 слов со всеми девятью буквами; смешанный шала-казахский, где казахский идёт вместе с русским; накладная с табличной сеткой и жирными заголовками; и «скан» первого образца — 150 dpi, поворот на 2°, лёгкое размытие и шум в JPEG.
Как связано с вашей задачейНебольшая выборка: цифры показывают тенденцию, а не точность на всём казахском.
Как связано с вашей задачейЧёткий печатный текст движок читает хорошо — это и есть рабочая зона.
Как связано с вашей задачейТаблицы и жирные шапки — место, где нужен контроль или постобработка.
Три набора языков повторяют реальный выбор в продукте: eng+rus+kaz (как в DocScan), kaz+rus и rus. Именно разница между ними объясняет большую часть результатов: наличие или отсутствие kaz переворачивает картину сильнее, чем смена модели.
Результаты по четырём образцам
Ниже — модель DocScan (web) и языки eng+rus+kaz, как в продукте. На чистом тексте и на «скане» ошибка почти нулевая, а вся проблемная зона — таблица. Числа взяты из results.csv, проценты округлены.
| Образец | Языки | CER | WER | Ошибки 9 казахских букв |
|---|---|---|---|---|
| 1. Чистый текст | eng+rus+kaz | 0,05% | 0,4% | 1 из 271 (0,4%) |
| 1. Чистый текст | rus | 14,9% | 68,1% | 271 из 271 (все) |
| 2. Смешанный шала-казахский | eng+rus+kaz | 0,31% | 2,1% | 0 из 44 |
| 2. Смешанный шала-казахский | rus | 7,6% | 36,5% | 44 из 44 (все) |
| 3. Накладная-таблица | eng+rus+kaz | 4,1% | 14,5% | 9 из 43 (21%) |
| 3. Накладная-таблица | kaz+rus | 2,4% | 9,6% | 4 из 43 (9,3%) |
| 4. «Скан» образца 1 | eng+rus+kaz | 0,21% | 1,2% | 4 из 271 (1,5%) |
| 4. «Скан» образца 1 | kaz+rus | 0,10% | 0,8% | 2 из 271 (0,7%) |
Видно две закономерности. Первая: без kaz казахский разваливается полностью — на чистом образце все 271 буква оказались неверными. Вторая: с kaz даже «плохой» скан читается лучше, чем таблица с идеальной печатью. Значит, дело не в качестве картинки, а в структуре: сетка и жирный шрифт создают движку больше проблем, чем шум.
Документы приходят на казахском, а распознавание настроено «по умолчанию», без проверки девяти букв.
На чётком печатном тексте замер даёт ошибку ниже 0,3% — этого достаточно, чтобы разгрузить первую линию.
«Ошибётся в сумме или названии». Справедливо для таблиц: там нужен контроль или постобработка, а не слепая вера.
«И так работает». Работает до первой накладной с жирной шапкой — поэтому стоит знать, где именно граница.
Отдельно про смешанный образец: чередование казахского и русского движок держит хорошо (CER 0,31%). Меньше букв — меньше шансов ошибиться, но и здесь видно, что при наличии kaz русский текст не мешает. В повседневной переписке на двух языках это важно: не нужно выбирать один язык на весь документ.
Какие казахские буквы ошибаются чаще?
Сводная таблица по буквам показывает, где движок спотыкается. Данные — web-модель с eng+rus+kaz по всем четырём образцам вместе, из per-letter.csv. Для девяти букв важно и то, во что именно они превращаются.
| Буква | Встреч | Ошибок | Доля | Частые подмены |
|---|---|---|---|---|
| ә | 40 | 0 | 0% | — |
| ғ | 63 | 0 | 0% | — |
| қ | 139 | 5 | 3,6% | к, К |
| ң | 54 | 1 | 1,9% | н |
| ө | 53 | 0 | 0% | — |
| ұ | 24 | 2 | 8,3% | У |
| ү | 42 | 2 | 4,8% | У, у |
| һ | 2 | 1 | 50% | — |
| і | 212 | 3 | 1,4% | регистр, ! и 1 |
С kaz+rus, без eng, ошибок примерно вдвое меньше: на тех же образцах ұ падает с 8,3% до 4,2%, ү до нуля, і с 1,4% до 0,9%. Лишний латинский язык в наборе добавляет движку соблазн прочитать казахскую букву как похожую латинскую — отсюда редкие, но неприятные замены вроде БСН → BCH.
Вторая частая беда — регистр. На чистом тексте из ошибок нашлась одна: Іле → іле. Для человека это мелочь, а для поля «ИИН/БСН» или начала имени — уже нет. Поэтому проверять стоит не только сами буквы, но и заглавные в начале слов.
Чистый печатный текст
Здесь движок почти не ошибается: CER 0,05%, одна ошибка на 271 казахскую букву. Это рабочая зона, где распознавание можно доверить без ручной вычитки — при условии, что язык kaz подключён.
Смешанный казахско-русский
Шала-казахский с чередованием языков читается хорошо: CER 0,31%, ошибок казахских букв нет. Важна не чистота языка, а наличие kaz в наборе: он не мешает русскому и не ломает казахские буквы.
Накладная и таблицы
Худший результат среди печатных образцов: CER 4,1% и каждая пятая казахская буква неверна. Виноваты сетка, жирная шапка и капс. Здесь распознавание лучше страховать: убрать eng, взять tessdata_best или проверять поля вручную.
Таблица честно мала: һ встретилась всего дважды, поэтому её 50% — это одна ошибка, а не статистика. Так же осторожно стоит читать редкие подмены: они показывают направление, а не устойчивую частоту. Размер выборки мы не прячем — он в первом столбце.
Как повели себя разные модели Tesseract?
Разница между моделями проявляется не на простом тексте, а на таблице — и там она решающая. На накладной с kaz+rus точная tessdata_best дала ноль ошибок казахских букв, системная tessdata_fast — 28%, а web-модель DocScan — 9,3%. На чистом тексте все три идут ноздря в ноздрю.
| Модель (накладная, kaz+rus) | CER | WER | Ошибки казахских букв |
|---|---|---|---|
| tessdata_fast (apt) | 3,7% | 16,9% | 12 из 43 (28%) |
| tessdata_best | 1,3% | 6,0% | 0 из 43 |
| web (модель DocScan) | 2,4% | 9,6% | 4 из 43 (9,3%) |
При eng+rus+kaz картина хуже у всех: у tessdata_fast на накладной ошибки букв подскакивают до 40%. То есть eng — не бесплатное дополнение: на капсе и в таблицах он даёт движку латинские варианты, и тот ими пользуется. Практический вывод для настройки: для казахских документов держать kaz+rus, а eng добавлять только осознанно.
Сами модели под лицензией Apache-2.0, поэтому мы их не перепубликуем, а даём ссылки и sha256 для сверки. Значения ниже — сокращённые (начало…конец) из отчёта; полные совпадают с выводом sha256sum models/*/*.
| Набор | Модель | Ссылка на оригинал | sha256 |
|---|---|---|---|
| tessdata_fast (apt) | kaz | github.com/tesseract-ocr/tessdata_fast | fcc01eed…eae53d |
| tessdata_fast (apt) | rus | tessdata_fast | e16e5e03…dbdf225 |
| tessdata_fast (apt) | eng | tessdata_fast | 7d4322bd…170b2 |
| tessdata_best | kaz | tessdata_best | 34cbd920…95aea9d |
| tessdata_best | rus | tessdata_best | b617eb68…dfb6b6 |
| web (модель DocScan) | kaz | kaz.traineddata.gz | 472b8b23…ee7517 |
| web (модель DocScan) | rus | rus.traineddata.gz | eb9be824…6ad6d |
Как выглядит один документ на входе и на выходе
- ВходящееДокумент попадает в распознавание
Печатный казахский, смешанный текст или накладная с таблицей — картинка уходит движку с выбранным набором языков.
- УчётДвижок читает и выравнивает символы
Tesseract распознаёт текст, а замер сравнивает его с эталоном и помечает расхождения по буквам.
- Повторное касаниеОшибки видны по типам
Қ превращается в К, ұ в У, і теряет регистр — каждой подмене можно сопоставить пару для постобработки.
- ИтогРешение о проверке
Чёткий текст идёт дальше автоматически, таблицы и капс уходят на вычитку или в постобработку по словарю.
Здесь же уместно сказать про продукты. Распознавание встраивается в общий контур: ИИ-агент в чатах принимает обращения, единый инбокс собирает каналы, а платформа аитоматон связывает документ со сделкой и ответственным. Сам замер — про движок; как он ляжет в процесс, зависит от того, где стоит человек.
Как цифры связаны с вашей задачей
- ЦифраБез kaz: все 271 казахские буквы неверныЧто это значит для васРусская или латинская модель не различает казахские буквы вовсе.Что отвечает в аитоматонНабор с языком kaz: движок видит девять специфических букв.ЦенностьКазахский текст вообще становится распознаваемым.
- ЦифраТаблица: каждая пятая буква неверна (21%)Что это значит для васСетка, капс и жирный шрифт — главный источник ошибок.Что отвечает в аитоматонkaz+rus без eng и модель tessdata_best: ошибки падают до нуля.ЦенностьРеквизиты и суммы в накладной читаются надёжнее.
- ЦифраІле → іле, БСН → BCHЧто это значит для васОшибки редкие, но в важных полях — дорогие.Что отвечает в аитоматонПостобработка по словарю и вычитка спорных полей человеком.ЦенностьОшибка не уходит клиенту: её ловят до отправки.
Ни одна модель не даёт права не проверять. Даже лучший результат на таблице у tessdata_best — это ноль ошибок на одном образце из сорока трёх букв, а не обещание на всех документах. Модель снимает часть рутины, а решение о том, что считать верным, остаётся за человеком.
Чего этот замер не показывает?
Замер не заменяет проверку на ваших документах: он говорит о тенденции, а не о гарантии. Всего четыре документа и около 630 казахских букв, отрисованных шрифтом DejaVu Sans. Реальные сканы, факсы, фото с телефона и рукописный текст мы не проверяли — там ошибок ожидаемо больше, чем на этих образцах.
Второе ограничение — среда. Здесь работает офлайн CLI-движок, а в браузере DocScan использует tesseract.js: у него другая сборка WASM и своя предобработка. Постобработку /api/ai-enhance мы намеренно не включали, поэтому цифры показывают «сырой» движок. Это не отчёт о качестве продукта, а открытый замер одной из его частей.
Третье — сами формулировки. Мы сознательно говорим «замер Tesseract на казахском», а не «распознаёт любые документы» и не «точность 99%»: данных для таких обещаний нет. Хорошие цифры на печатном тексте и слабое место в таблицах — это две стороны одного результата, и обе стоит учитывать.
Как повторить замер на своих документах?
Возьмите наши материалы и прогоните тот же движок на своих образцах — так вы получите цифру для своей задачи. Всё наше открыто под лицензией CC BY 4.0: результаты, ошибки по буквам, образцы, эталоны и скрипты. Модели Tesseract скачиваются по ссылкам из раздела про модели; мы их не перепубликуем.
Материалы замера:
- results.csv — CER, WER и ошибки по образцам, моделям и языкам;
- per-letter.csv — ошибки по буквам с частыми подменами;
- образец чистого текста — и остальные картинки в той же папке;
- эталон чистого текста — и остальные тексты эталонов;
- render.py — отрисовка образцов;
- score.py — прогон Tesseract и подсчёт метрик.
- Подготовьте окружениеПоставьте tesseract 5.5, Pillow, numpy и jiwer. Скачайте модели в папки models/fast, models/best и models/web по ссылкам из раздела про модели и сверьте sha256.
- Сгенерируйте образцыЗапустите render.py — он отрисует четыре образца из gt/*.txt и «скан» из первого. Для своих данных положите картинки в samples/, а тексты — в gt/.
- Прогоните и посчитайтеЗапустите score.py: он выполнит Tesseract в нужных языках и запишет свежие results.csv и per-letter.csv с CER, WER и ошибками по буквам.
- Смотрите на разрез по буквамСравнивайте не только общий CER, но и таблицу по девяти буквам — именно она показывает, можно ли доверять документу без вычитки.
Если своего пайплайна нет, начните с малого: возьмите десяток реальных документов на казахском, которые уже проходят через ваши процессы, и повторите замер на них. Такой тест займёт вечер и даст куда более полезную цифру, чем любая чужая. А где ответ дорогой — там распознавание готовит черновик, а человек принимает решение.